


SiFive 博客
来自 RISC-V 专家的最新洞察与深度技术解析

数据中心 AI 的下一次飞跃:借助 SiFive 智能控制单元 (ACU) 编排定制加速器
SiFive 智能控制技术赋能可编程 RISC-V 解决方案,优化、控制并引导定制加速器的运行,释放新一代 AI 性能潜力。
随着智能体 AI、多模态模型和实时推理在数据中心及边缘系统中的应用不断拓展,工作负载正变得日益复杂、多样,对计算能力的要求也越来越高。为满足这些需求,计算架构设计人员正转向专用定制加速器,以针对矩阵乘法等特定运算提供更高的性能和能效。然而,这些加速器仍需依靠数据通路之外的软件进行配置、供数、同步和监控,并获得相应的软件支持。
“传统”加速器控制方式的局限性
传统的控制方法与设计方案带来了设计上的挑战。数据中心系统级处理器对于实现系统级编排仍然不可或缺,但若将每一项底层控制决策都交由该处理器处理,不仅会占用系统资源、增加复杂性,还会引入额外延迟。
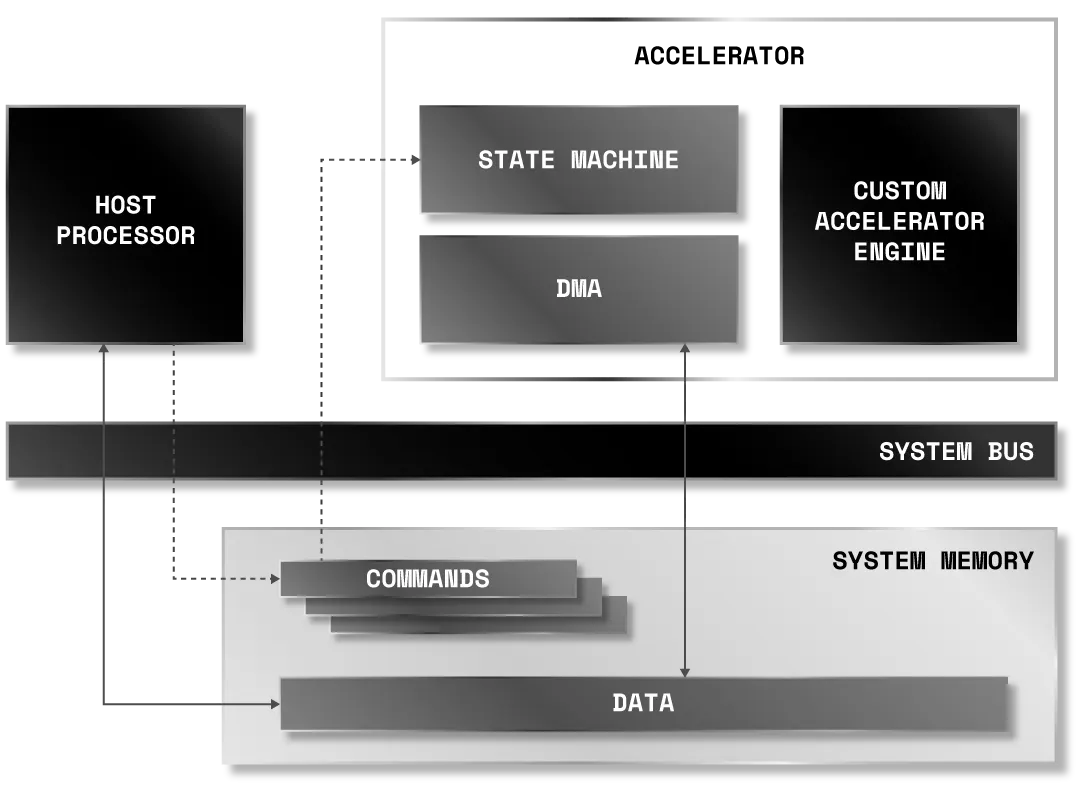
硬连线的本地控制方式 (例如采用专用系统总线、映射控制寄存器和直接内存访问 (DMA)) 能够实现高效且时序可预测的控制,但这类方案通常属于定制的专有解决方案。一旦算法、数据格式和系统需求发生变化,这类方案便难以适应相应的修改需求。传统的定制加速器控制架构存在以下问题:
-
功能僵化且固定不变: 硬连线状态机意味着,一旦算法发生变化或发现程序错误,往往就需要重新进行硬件设计和流片,成本高昂。
-
共享总线瓶颈: 过共享总线频繁传输数据会引入难以接受的延迟,并导致内存执行流水线停滞。
-
主机 CPU 开销过高: 让主处理器负责复杂的编排工作,会限制整个系统的性能和能效。
要构建新一代数据中心 AI 基础设施,我们需要实现范式转变,摆脱对固定状态机的依赖。单纯增强系统级处理器的能力,或增加其负载及相关数据基础设施,并非解决之道。
解决办法是在定制加速器附近增加一个可编程的控制与计算层,分担系统级处理器的部分工作。该层负责低延迟命令分发、数据移动、预处理与后处理,以及工作负载和算法的调整,同时与系统级处理器协同工作,直接优化专用定制加速器引擎的运行。
SiFive Intelligence 系列加速器控制单元 (ACU) 登场
为应对这一挑战,SiFive 开发了 SiFive Intelligence 系列计算引擎,使其成为理想的加速器控制单元 (ACU)。该系列将可编程 RISC-V 标量与向量计算能力相结合,并支持与定制加速器直接连接。Intelligence 计算 IP 本身就可以作为出色的边缘推理引擎,而这些核心与核心复合体也经过专门设计,旨在成为专用可编程 RISC-V 前端控制器的优选方案,用以指挥和控制定制加速器。
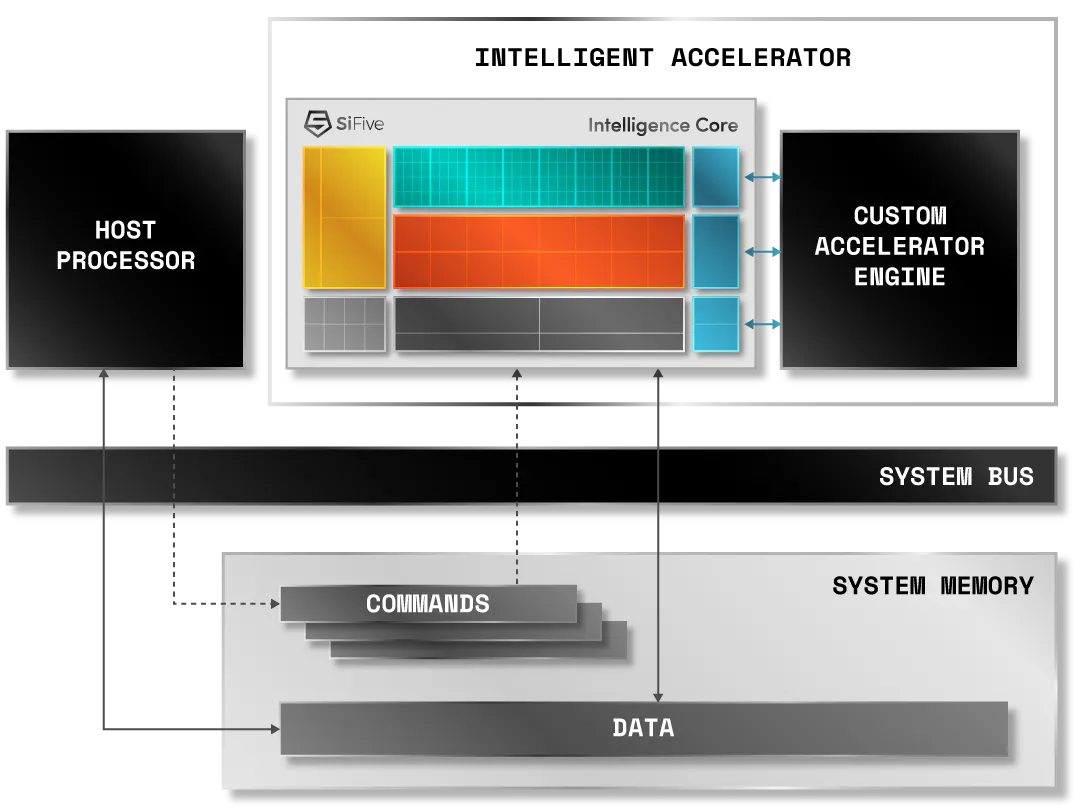
SiFive ACU 充当智能编排层,负责接管任务调度、资源分配、命令分发以及数据的预处理和后处理,从而分担主机处理器的工作负载。这使 AI 架构设计人员能够专注于设计专用 AI 定制加速器引擎,而成熟可靠的 SiFive IP ACU 解决方案则负责控制、协调和软件可编程性,并支持不断演进的工作负载。
通过用基于 SiFive Intelligence 系列的 ACU 取代传统控制方案,数据中心架构设计人员将能从一开始就获得面向未来的适应能力。由于 ACU 基于可编程 RISC-V 内核构建,因此更新和错误修复可以通过简单的软件和固件补丁来部署,而无需进行代价高昂的硬件迭代。此外,SiFive 采用 100% 基于开放标准的 RISC-V 指令集架构 (ISA),并兼容 RVA23.1 (RTOS、Linux),可直接接入丰富成熟的行业软件生态,从而大幅缩短产品上市时间。
-
可编程 RISC-V 控制器: 作为灵活的前端控制器,负责管理定制 AI 加速器。
-
减轻主机处理器负担: 负责任务调度、命令分发和数据格式处理,从而减轻主机 CPU 的负担,甚至取代主机 CPU(包括运行 Linux 的主机 CPU)。
-
软件驱动的适应能力: 可通过固件补丁轻松实现更新,同时借助开放的 RISC-V 软件生态缩短产品上市时间。
借助 SSCI、VCIX 和 CLP 突破数据搬运瓶颈
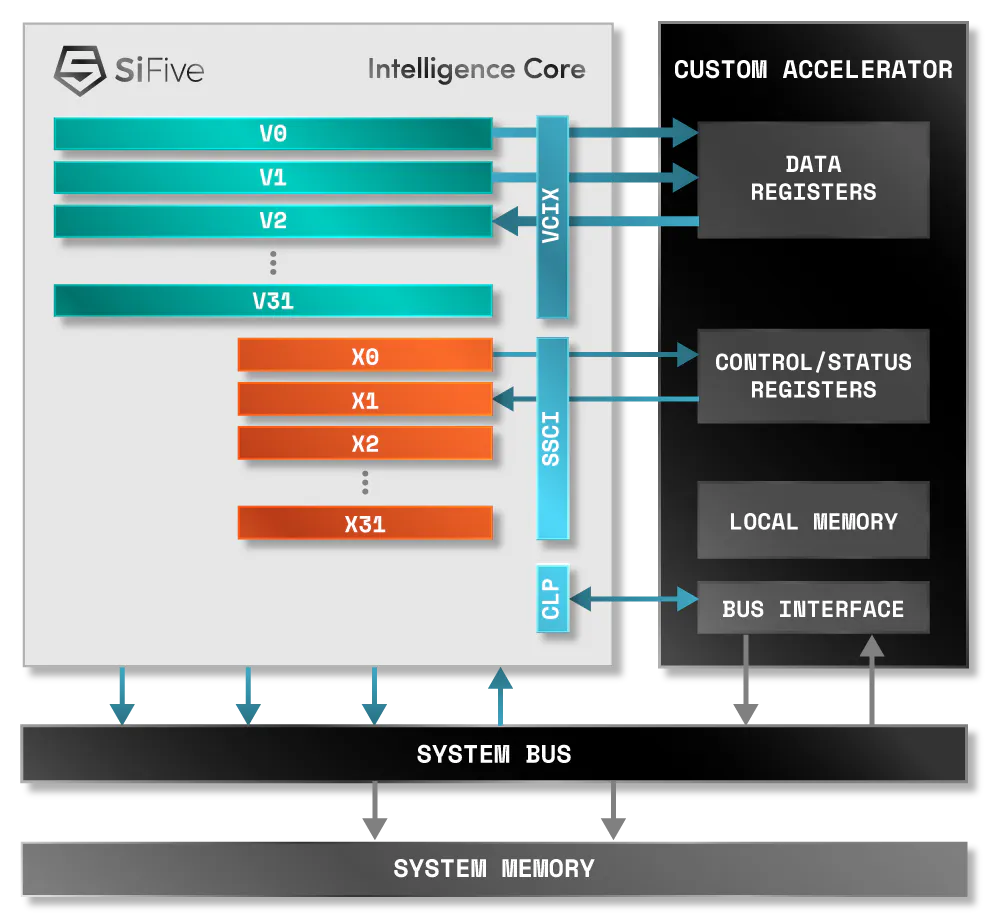
在 AI 硬件设计中,试图通过单一共享总线同时实现低延迟的引擎控制和大规模高带宽数据传输,势必会导致性能下降。SiFive 通过采用三种业界领先的直接流水线接口,构建同步的编排工作流,从而解决这一难题:
-
向量 ACU/协处理器接口 (VCIX): VCIX 旨在确保高负载计算引擎持续获得所需数据,提供与 SiFive Intelligence 核心向量寄存器直接连接的高带宽接口。它能够以核心时钟频率,将打包的张量和矩阵数据集直接高速流式传输到定制硬件加速器。
-
SiFive 标量 ACU/协处理器接口 (SSCI): SSCI 专为低延迟控制而设计,直接接入 SiFive 标量 CPU 的执行流水线。它通过分发定制标量指令、处理依赖数据的决策,以及以单周期或超低延迟完成控制寄存器的读写操作,确保定制加速器引擎能够快速响应。
-
核心本地端口 (CLP): 当 AI 核心需要旁路级的速度时,CLP 可提供一条高带宽、低延迟的数据通路,直接连接到本地 RAM 或客户 RAM,完全绕过 L2 子系统。
在实际应用中,这些接口能够支持跨不同 IP 模块和内存层级的 AI 工作流,实现高效编排。SiFive ACU 利用其向量单元和 VCIX,将权重或输入张量快速预加载到加速器的本地内存。数据加载就绪后,标量核心便通过 SSCI 分发一条自定义指令,触发矩阵计算。
最重要的是,如果 AI 工作负载需要进行数据预处理或后处理、执行 Softmax 运算或激活函数,或者运行定制加速器原本并未设计用于处理的全新算法,SiFive Intelligence 核心也能够同时执行这些任务。
不止适用于数据中心
虽然定制 AI 加速器与云端和数据中心工作负载密切相关,但包括 SiFive Intelligence 系列在内的 ACU,其设计目标是覆盖整个计算领域。从远端边缘物联网、汽车高级驾驶辅助系统 (ADAS)、物理 AI 和机器人,到智能边缘物联网、AR/VR 头显等消费级可穿戴设备及其他电池供电设备,ACU 都能提供多样化的解决方案,同时兼具灵活性。
为什么 ACU 的应用范围远不止数据中心:
-
边缘的功耗与散热约束: 数据中心拥有兆瓦级供电能力,而边缘设备则必须在严格的散热与功耗预算下运行。ACU 可管理功耗状态、高效调度任务,并防止高能耗的定制加速器在等待主机指令时处于空闲状态。
-
确定性实时响应: 机器人和自动驾驶汽车等应用要求即时响应。使用 ACU 作为低延迟的专用前端控制器,可以确保命令分发具有可预测的时序,而不必等待开销较大的主机操作系统处理。
-
独立主机运行能力: 较小的 SiFive ACU 核心可利用紧耦合内存 (TCM/SRAM) 运行实时操作系统 (RTOS),而高端核心则配备完整的内存管理单元 (MMU),能够直接运行 Linux。这使 ACU 能够完全取代主机处理器,大幅节省紧凑型边缘硬件的芯片面积、成本和功耗。物理 AI 与传感器融合协调:边缘 AI 依赖异构计算,需要融合视觉、音频、雷达和其他传感器的数据。ACU 充当编排层,负责对数据进行预处理和后处理,并实时向专用处理单元供数。
ACU 并非仅适用于数据中心。它是面向定制加速器的可编程 RISC-V 控制层,凡是需要管理加速器任务、搬运数据并减轻主 CPU 底层处理负担的系统,都能从中受益。无论是紧凑型嵌入式 SoC,还是服务器,ACU 都能发挥作用。
为数据中心工作负载选择合适的 ACU
定制芯片没有放之四海而皆准的解决方案。因此,SiFive Intelligence 产品系列采用可扩展设计,可根据控制复杂度、数据传输带宽以及备用计算需求灵活调整。为加速器控制单元 (ACU) 解决方案选择合适的 SiFive Intelligence 核心,需要综合权衡以下三大因素:
-
数据传输带宽
-
控制复杂度
-
辅助/备用计算需求
所选核心的向量长度 (VLEN) 和数据通路宽度 (DLEN) 决定了通过协处理器接口可实现的数据传输带宽,以及 ACU 本身的计算能力。
X100 系列: 适用于控制需求较高或追求高能效的边缘加速器。这类加速器主要通过 SSCI 进行指令分发和状态检查。X100 系列能够以极低的延迟完成控制任务,同时避免浪费芯片面积;此外,还可搭配可扩展的紧耦合内存 (TCM/SRAM) 和实时操作系统 (RTOS) 运行。
案例研究:一家美国一级半导体公司获准采用 SiFive Intelligence X100,用于工业边缘 AI 应用。
X200 和 X300 系列:专为高带宽数据传输和大量辅助计算需求而设计。这些核心采用更宽的 VCIX 数据通路 (例如,VLEN 为 256 位、512 位或 1,024 位),可将数据传输能力提升至原来的 2 倍或 4 倍,从而确保大型矩阵计算引擎持续高效运行;同时,它们还配备完整的内存管理单元 (MMU),支持 Linux 运行环境。
案例研究:Google 数据中心采用 SiFive Intelligence X200 作为 AI 计算主机。
定制加速器硬件的未来在于软件
优化定制加速器的控制已不再是次要考量,而是正逐渐成为 AI 时代的关键成功因素。加速器引擎的数据吞吐能力必须不受主机处理器的限制,从而使定制引擎能够扩展至更大规模、以更快的速度处理数据,满足不断增长的需求。
人工智能与高性能计算工作负载的快速演进,要求采用一种兼顾软件长期稳定性与硬件快速创新的架构。RISC-V 软件生态通过建立标准化的软件基线,化解了专有技术锁定与生态碎片化之间的历史性矛盾,既保障了开发投入,又支持了特定领域的加速与创新。
标准化基础
- 兼容性与可移植性: 提供全球统一的标准指令集架构 (ISA) 及一致的扩展规范。标准化的 RISC-V ISA 为操作系统(如 Linux 和 RTOS)、编译器(如 GCC 和 LLVM)、开发工具及应用程序提供了通用基础,使软件能够在不同的 RISC-V 实现之间复用和移植,同时避免生态碎片化。
开放生态
- 协作与选择: 依托协作型社区和全球 RISC-V 生态,鼓励硬件厂商、软件开发者和行业合作伙伴协同创新,减少对单一供应商的依赖,并加快开发工具、开源编译器(如 LLVM)、AI 框架(包括 MLIR、ONNX Runtime 和 TFLite)及不受专有技术许可费用束缚的解决方案的开发。
定制化创新
- 灵活性与差异化: 设计人员可以扩展标准 RISC-V 指令集架构 (ISA),加入专用指令、向量/矩阵扩展,以及专用加速器控制逻辑接口(如 SSCI 和 VCIX),并利用 C 编译器内建函数加速快速演进的 AI、高性能计算 (HPC)、汽车及嵌入式计算应用,同时确保与基础软件栈的兼容性,并继续使用标准开发工具。
RISC-V 兼具标准化架构的兼容性、开放生态的优势以及创新的自由度,使差异化的计算解决方案能够在不牺牲通用软件基础的前提下实现。
SiFive Intelligence 系列 ACU 正是为驱动下一波创新浪潮而打造。通过将 RISC-V 的灵活性与卓越的连接能力相结合,我们让系统架构设计人员能够专注于自身所长,并为释放定制 AI 硬件的全部潜能提供强大支持,助力其应用于从数据中心、边缘计算到直接面向消费者的各种场景,以及介于其间的其他应用场景。
准备好简化硬件集成流程、加快设计进程,并最大限度地提升系统效率了吗?立即联系 SiFive 销售团队 预约架构评审,深入了解 SiFive Intelligence 系列 IP 如何助力加速实现下一代数据中心或其他 AI 技术突破。

Clifton Robin
Clifton Robin 现任 SiFive 技术产品营销总监,主要专注于 SiFive Intelligence AI 产品系列、物理 AI 及软件产品。他拥有电子工程学士学位,在半导体、CPU/GPU 架构及 AI/ML 领域拥有超过 30 年的从业经验,曾任职于 Intel、HP、Cable & Wireless 和 Rockwell Automation,擅长将复杂技术转化为具有差异化优势、以客户需求为中心的产品与解决方案,并清晰传达其价值。Clifton 曾荣获工程艾美奖,并拥有两项专利。他还因在打造以客户为中心的解决方案及技术传播方面的表现,获得了 20 多项行业及企业奖项。


Read more Insights from the RISC-V Experts

超越 CPU 与 GPU:SiFive 在数据中心基础设施中的应用

SiFive 视角:RISC-V SPMP 规范正式批准,助力嵌入式安全飞跃发展
